Riset Apple Minions Manfaatkan Mac Menganggur sebagai Komputasi AI Terdistribusi
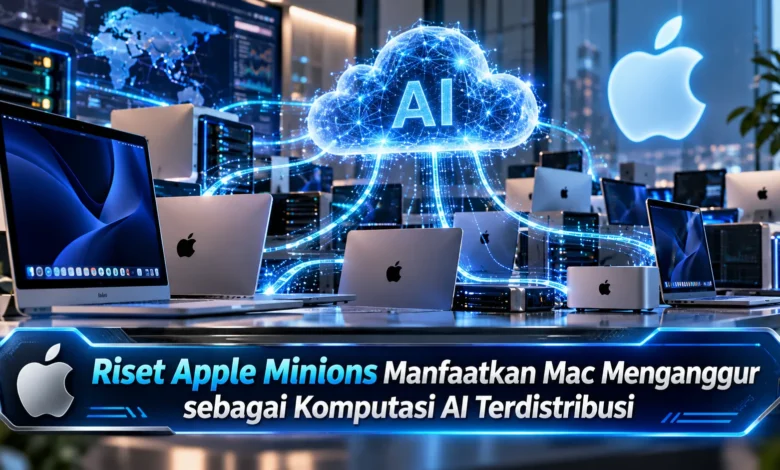
Apple mengembangkan pendekatan baru untuk memanfaatkan komputer Mac yang sedang tidak digunakan melalui sistem komputasi terdistribusi bernama Minions. Penelitian yang dipublikasikan pada Oktober 2026 ini memperlihatkan bagaimana GPU pada perangkat berbasis Apple Silicon dapat digabungkan menjadi sumber daya komputasi virtual untuk menjalankan tugas kecerdasan buatan. Inovasi TEKNOLOGI tersebut bertujuan mengurangi ketergantungan terhadap infrastruktur GPU terpusat yang sering menghadapi antrean pekerjaan dan biaya operasional tinggi. Dengan memanfaatkan kapasitas perangkat yang sudah tersedia, Minions menawarkan cara berbeda dalam mengelola inferensi AI, meningkatkan efisiensi penggunaan perangkat keras, dan mendistribusikan pekerjaan komputasi.
Apple Minions Mengubah Mac Menganggur Menjadi Infrastruktur AI
Pertumbuhan ekosistem komputasi AI terus meningkatkan kebutuhan perangkat keras yang dapat menjalankan model bahasa berukuran besar. Pada pendekatan konvensional, tugas inferensi biasanya dijalankan melalui infrastruktur khusus. Di balik kemampuan tersebut, ketersediaan perangkat GPU tidak selalu mencukupi. Permasalahan tersebut berpotensi menimbulkan antrean pekerjaan ketika sumber daya server sedang digunakan secara intensif. Untuk mengatasi persoalan tersebut, peneliti Apple merancang sistem Minions yang menggabungkan kapasitas pemrosesan perangkat Apple Silicon.
Pengembangan ini dipaparkan pada penelitian berjudul Minions: A Dynamic and Distributed Virtual GPU Cloud Built on Idle Apple Silicon Devices yang tersedia sebagai makalah penelitian Oktober 2026. Makalah ilmiah ini menjelaskan cara mengumpulkan sumber daya grafis Apple Silicon menjadi kumpulan komputasi terdistribusi. Alih-alih membeli perangkat baru, organisasi mampu memanfaatkan kapasitas komputasi yang belum terpakai. Konsep komputasi terdistribusi tersebut diharapkan membantu memperbaiki efisiensi operasional. Meski menawarkan potensi menarik, Minions belum menjadi layanan publik untuk seluruh pemilik Mac.
Mekanisme Komputasi Terdistribusi Apple Silicon untuk Inferensi
Infrastruktur virtual GPU cloud tersebut memanfaatkan koordinasi berbagai mesin macOS yang menyediakan sumber daya grafis menganggur. Ketika tugas AI dikirimkan, sistem membagi pekerjaan menjadi bagian lebih kecil. Subtugas tersebut kemudian dijalankan pada komputer yang siap menerima tugas. Dengan menggunakan pendekatan tersebut, kapasitas GPU dapat dimanfaatkan dari banyak perangkat. Setelah pemrosesan selesai, keluaran disimpan untuk digunakan lebih lanjut. Pada tahapan akhir, sistem mengumpulkan keluaran yang dibutuhkan.
Salah satu karakteristik penting Minions adalah mekanisme eksekusi pull-based. Berbeda dari sistem yang selalu menentukan perangkat secara terpusat, komputer yang siap menjalankan subtugas mengakses daftar pekerjaan yang menunggu. Model pembagian tugas ini mendukung partisipasi komputer yang tidak selalu aktif. Dalam lingkungan perkantoran, sebuah Mac berpotensi menyediakan kapasitas saat tidak digunakan secara intensif. Apabila pemilik mulai menjalankan pekerjaan berat, sistem perlu mengurangi ketergantungan pada perangkat tersebut. Karena itu, fleksibilitas distribusi merupakan bagian utama rancangan.
Komponen Utama Infrastruktur AI Terdistribusi Minions
Pada rancangan sistem yang diteliti, Apple menggunakan beberapa komponen, termasuk Minion Server, Minion Executor, dan Minion Watchdog. Minion Server berperan dalam membagi permintaan komputasi menjadi unit kerja yang lebih kecil. Adapun pada komputer Mac, Minion Executor menjalankan proses pengambilan serta eksekusi. Layanan eksekusi ini menjalankan komputasi melalui sumber daya lokal untuk memproses data yang diberikan. Layanan watchdog sistem berperan dalam pengawasan layanan agar pekerjaan tidak mudah terhenti akibat gangguan.
Dalam implementasi yang dijelaskan, pengelolaan subtugas memanfaatkan PostgreSQL. Komunikasi antara perangkat dan server dilakukan melalui layanan REST. Selain itu, Amazon S3 digunakan sebagai penyimpanan objek. Ketika sebuah Mac menerima tugas, komputer tersebut mengakses masukan komputasi dan memuat model AI bila dibutuhkan. Setelah inferensi dijalankan, hasil dikirim kembali ke penyimpanan. Arsitektur berbasis komponen ini memberikan struktur bagi pengoperasian banyak perangkat.
Keunggulan GPU Mac untuk Menjalankan Inferensi Kecerdasan Buatan
Penggunaan prosesor Apple dalam Minions berkaitan dengan kemampuan GPU terintegrasinya. Sistem macOS dengan chip Apple menawarkan kemampuan pemrosesan paralel untuk model kecerdasan buatan. Dalam aktivitas sehari-hari, sebagian kemampuan akselerasi mungkin tetap menganggur. Minions berupaya memanfaatkan sumber daya pemrosesan yang tersedia untuk melaksanakan tugas pembelajaran mesin. Berkat pemanfaatan perangkat yang sudah dimiliki, organisasi memiliki alternatif sumber daya AI tanpa harus memperbesar pusat data untuk semua tugas.
Dalam membaca hasil penelitian ini, penting diketahui bahwa Minions dirancang menjalankan tahap penggunaan model AI, bukan pelatihan model besar secara terdistribusi pada implementasi yang dipaparkan. Proses inference merupakan pemrosesan permintaan menggunakan jaringan neural yang telah dikembangkan. Dalam penelitian Apple tersebut, pekerjaan komputasi mencakup pembentukan embedding teks menggunakan model transformer terbuka. Tidak hanya memproses embedding, Minions menjalankan pembuatan teks menggunakan LLM dengan memanfaatkan perangkat lunak Ollama pada perangkat yang berpartisipasi. Dua jenis beban kerja tersebut memperlihatkan jenis pekerjaan yang diuji secara lebih terarah.
Efisiensi Infrastruktur GPU melalui Pemanfaatan Mac Menganggur
Motivasi penting pengembangan Minions adalah keterbatasan kapasitas GPU terpusat. Ketika banyak pekerjaan berjalan bersamaan, pekerjaan berpotensi tertunda. Dalam pengalaman operasional yang dibahas, sejumlah permintaan komputasi mengalami penundaan selama lebih dari sepuluh jam. Setelah menggunakan kapasitas perangkat yang tersedia, waktu tunggu untuk beberapa tugas dapat turun hingga hitungan menit. Namun demikian, manfaat waktu tunggu dapat berbeda menurut jenis inferensi. Ketersediaan GPU menjadi faktor penentu.
Tidak hanya mempercepat akses terhadap kapasitas, Minions dapat membantu menggunakan aset teknologi secara lebih maksimal. Komputer Mac yang dimiliki organisasi sering menjalankan tugas utama pengguna. Pada waktu beban kerja lokal sedang ringan, sumber daya grafis berpotensi menjalankan inferensi tambahan. Walaupun mengurangi kebutuhan pembelian perangkat baru, penghematan biaya tidak dapat diasumsikan secara otomatis. Konsumsi energi tambahan, pengelolaan jaringan, dan pengaruh beban komputasi pada aktivitas utama perlu dimasukkan dalam perhitungan. Melalui pengukuran operasional, pendekatan Minions dapat membantu memaksimalkan aset komputasi.
Prospek Pengembangan Minions untuk Infrastruktur AI yang Lebih Luas
Kendati pendekatan Apple memiliki sejumlah manfaat, perlindungan informasi membutuhkan pengelolaan khusus. Ketika pekerjaan AI dijalankan pada banyak komputer, pengelolaan izin menjadi semakin penting. Pada laporan penggunaan sistem tersebut, sebagian tim mempertanyakan keamanan pemrosesan data di perangkat kelompok lain. Persoalan pengelolaan data ini menunjukkan pentingnya pengendalian akses. Mekanisme seperti autentikasi perangkat, pembatasan data sensitif, serta pencatatan aktivitas komputasi. Jika perlindungan tidak dirancang secara matang, efisiensi sistem dapat dibayangi persoalan keamanan informasi.
Dalam penelitian berikutnya, tim Apple membuka kemungkinan perluasan sistem dari inferensi menuju pekerjaan pembelajaran mesin yang lebih kompleks. Perlu dipahami bahwa, arah pengembangan itu belum berarti Minions telah mendukung semua tugas training. Para peneliti juga membahas kemungkinan menggabungkan Mac dari berbagai organisasi apabila pengelolaan kepercayaan antarmesin berhasil diterapkan. Gagasan federasi sumber daya tersebut berpotensi membentuk jaringan GPU bersama. Meski demikian, partisipasi komputer pribadi secara global belum menjadi kemampuan publik. Keberhasilan pengembangan akan bergantung pada keamanan dan keandalan.
Masa Depan Virtual GPU Cloud melalui Pemanfaatan Apple Silicon
Penelitian Apple Minions memberikan gambaran baru dalam pemanfaatan TEKNOLOGI kecerdasan buatan. Berkat distribusi pekerjaan ke perangkat macOS yang tersedia, Minions mampu menyediakan kapasitas inferensi tambahan tanpa menambah perangkat GPU khusus untuk seluruh beban kerja. Kemampuan membagi pekerjaan secara dinamis mendukung keandalan pengelolaan kapasitas ketika beban kerja perangkat tidak selalu sama. Walaupun hasil penelitian menjanjikan, keamanan informasi dan biaya operasional tetap perlu diperhatikan. Sebagai catatan penting, kemampuan pelatihan model terdistribusi masih termasuk arah pengembangan. Seberapa menarik menurut Anda pemanfaatan Mac menganggur untuk AI? Mari sampaikan pandangan dan pengalaman Anda mengenai peluang memanfaatkan perangkat yang sudah tersedia untuk kebutuhan kecerdasan buatan.